Vista previa
Conocé el recurso antes de descargarlo
Resumen
Qué resuelve esta plantilla
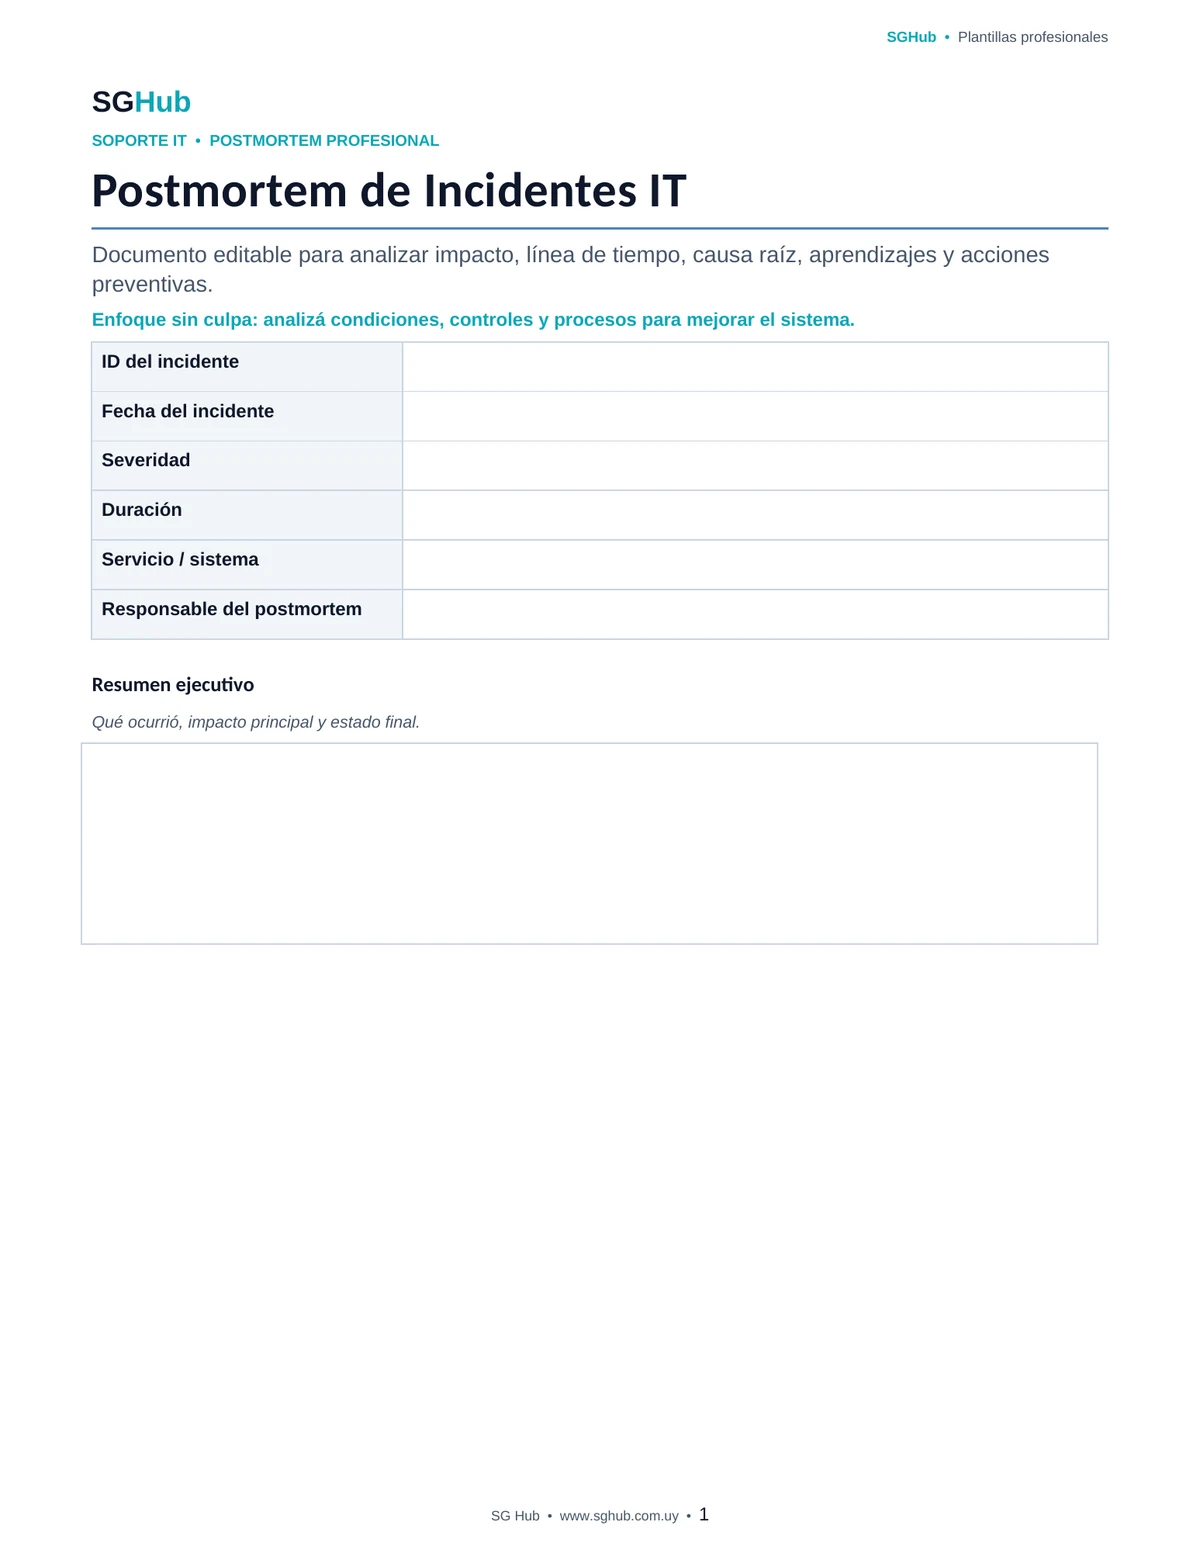
Esta plantilla está diseñada para realizar un análisis postmortem estructurado después de un incidente relevante de aplicaciones, infraestructura, integraciones, datos o servicios digitales. Permite reconstruir qué ocurrió, cuándo comenzó, cómo fue detectado, qué impacto tuvo, qué decisiones se tomaron y cuáles fueron las causas técnicas u operativas que permitieron que el incidente sucediera. El objetivo no es buscar culpables, sino identificar fallas del sistema, procesos, controles, documentación o comunicación y transformarlas en acciones de mejora verificables.
Público
¿Para quién está pensada?
- ✓Equipos de soporte IT y soporte de aplicaciones que participan en incidentes productivos.
- ✓SRE, DevOps, infraestructura y operaciones responsables de disponibilidad y continuidad de servicios.
- ✓Desarrolladores y líderes técnicos que necesitan analizar fallas y prevenir recurrencias.
- ✓Analistas funcionales y responsables de producto afectados por incidentes en procesos de negocio.
- ✓Service Managers, Incident Managers y responsables de operaciones que coordinan revisiones posteriores.
- ✓Equipos pequeños que necesitan una forma simple y profesional de documentar aprendizajes después de un incidente.
Contenido
Qué incluye
- ✓Resumen ejecutivo del incidente y estado final.
- ✓Fecha, duración y servicios o procesos afectados.
- ✓Descripción del impacto técnico y de negocio.
- ✓Línea de tiempo detallada desde el inicio hasta la recuperación.
- ✓Método y momento de detección del incidente.
- ✓Acciones de mitigación y recuperación realizadas.
- ✓Causa raíz confirmada o nivel de certeza del análisis.
- ✓Factores contribuyentes técnicos, operativos y humanos.
- ✓Controles que funcionaron correctamente durante el incidente.
- ✓Controles, alertas o procesos que no funcionaron como se esperaba.
- ✓Decisiones clave tomadas durante la respuesta.
- ✓Qué salió bien y qué podría mejorarse.
- ✓Aprendizajes técnicos y operativos.
- ✓Acciones correctivas y preventivas con responsables y fechas objetivo.
- ✓Criterios para verificar que cada acción de mejora fue completada.
Aplicación
Cuándo usar esta plantilla
Analizar un incidente productivo crítico después de restaurar el servicio.
Documentar una caída de aplicación, API, base de datos o infraestructura.
Revisar incidentes recurrentes para identificar causas estructurales.
Analizar una degradación de rendimiento que afectó usuarios o procesos de negocio.
Documentar fallas de despliegue, configuración, integración o cambio operativo.
Registrar aprendizajes después de un incidente causado por datos incorrectos o procesos automatizados.
Generar acciones preventivas antes de una próxima release o cambio importante.
Compartir conocimiento con equipos que no participaron directamente en el incidente.
Paso a paso
Cómo utilizarla
Paso 1
Completá primero un resumen objetivo del incidente, su duración, servicios afectados e impacto sin entrar todavía en conclusiones sobre la causa.
Paso 2
Reconstruí la línea de tiempo utilizando logs, alertas, tickets, mensajes y registros de acciones para reducir dependencias de la memoria.
Paso 3
Documentá cómo fue detectado el incidente y evaluá si la detección ocurrió en el momento esperado o demasiado tarde.
Paso 4
Registrá las acciones de mitigación y recuperación indicando qué resultado produjo cada una.
Paso 5
Analizá la causa raíz diferenciándola de síntomas, detonantes y factores contribuyentes.
Paso 6
Identificá qué controles, alertas, procesos o decisiones ayudaron a limitar el impacto.
Paso 7
Registrá también qué controles o procesos fallaron, faltaban o generaron demoras durante la respuesta.
Paso 8
Documentá qué salió bien, qué debería cambiar y qué aprendizajes pueden reutilizarse en otros sistemas o equipos.
Paso 9
Convertí cada aprendizaje relevante en una acción concreta con responsable, prioridad, fecha objetivo y criterio de finalización.
Paso 10
Revisá posteriormente las acciones abiertas y cerrá el postmortem solamente cuando exista seguimiento sobre las mejoras comprometidas.
Personalización
Cómo adaptarla a tu caso
- ✓Adaptá el nivel de detalle a la severidad del incidente: una indisponibilidad crítica requiere más profundidad que un evento menor sin impacto significativo.
- ✓Agregá métricas como tiempo hasta detección, tiempo hasta mitigación y tiempo hasta recuperación si tu equipo las utiliza.
- ✓Incluí enlaces a dashboards, alertas, tickets, commits, cambios, releases o documentación técnica para mantener evidencia trazable.
- ✓Si trabajás con varias áreas, agregá una sección de participantes y responsabilidades durante la respuesta.
- ✓Podés incorporar una matriz de acciones con prioridad, esfuerzo, responsable, fecha objetivo, estado y evidencia de cierre.
Importante
Qué revisar antes de usarla
- ✓El postmortem debe centrarse en condiciones, decisiones y sistemas que permitieron el incidente, evitando convertir el análisis en una búsqueda de culpables.
- ✓No confundas el detonante inmediato con la causa raíz: una acción puntual puede iniciar el incidente mientras que controles insuficientes permiten que genere impacto.
- ✓Las acciones de mejora deben ser específicas y verificables; expresiones como “tener más cuidado” no constituyen una medida preventiva sólida.
- ✓No incluyas secretos, credenciales, tokens o datos sensibles en logs, capturas o referencias adjuntas al documento.
Evitalos
Errores frecuentes
- ✓Realizar el postmortem demasiado tarde y depender solamente de recuerdos de los participantes.
- ✓Describir únicamente la causa técnica sin analizar factores de proceso, monitoreo, comunicación o documentación.
- ✓Asignar culpa a una persona en lugar de analizar por qué el sistema permitió que una acción individual generara un incidente.
- ✓Confundir síntomas, detonantes y causa raíz dentro de una misma conclusión.
- ✓Omitir decisiones importantes tomadas durante la mitigación y recuperación.
- ✓No registrar qué controles funcionaron correctamente y deberían conservarse.
- ✓Crear acciones de mejora demasiado generales o sin responsable.
- ✓Definir acciones sin fecha objetivo ni criterio claro para considerarlas completadas.
- ✓Cerrar el postmortem sin hacer seguimiento de las acciones preventivas.
- ✓Compartir evidencia que contiene credenciales, tokens, datos personales u otra información sensible.
Control final
Checklist antes de terminar
- ✓El incidente tiene un resumen ejecutivo claro.
- ✓La duración y los servicios afectados están documentados.
- ✓El impacto técnico y de negocio está identificado.
- ✓La línea de tiempo fue reconstruida con evidencias disponibles.
- ✓El método y tiempo de detección están registrados.
- ✓Las acciones de mitigación y recuperación están documentadas.
- ✓La causa raíz está diferenciada de síntomas y detonantes.
- ✓Los factores contribuyentes fueron identificados.
- ✓Se documentó qué funcionó bien durante la respuesta.
- ✓Se documentó qué controles o procesos fallaron o faltaban.
- ✓Las decisiones relevantes quedaron registradas.
- ✓Los aprendizajes son concretos y reutilizables.
- ✓Cada acción de mejora tiene responsable.
- ✓Cada acción de mejora tiene prioridad y fecha objetivo.
- ✓Cada acción tiene un criterio verificable de finalización.
- ✓No se incluyeron secretos ni datos sensibles en la documentación.
Formato
Detalles del archivo
Documento editable orientado al análisis posterior de incidentes IT y de producción. La estructura permite registrar resumen, impacto, detección, línea de tiempo, mitigación, causa raíz, factores contribuyentes, aprendizajes y acciones correctivas o preventivas. Puede utilizarse como documento individual por incidente y complementarse con tickets, métricas, dashboards, logs, cambios y documentación técnica relacionada.
Preguntas frecuentes
Antes de descargar
¿Qué es un postmortem de incidentes?
Es un análisis estructurado realizado después de estabilizar y resolver un incidente. Busca comprender qué ocurrió, por qué tuvo impacto, qué funcionó durante la respuesta y qué cambios pueden reducir la probabilidad o gravedad de futuras recurrencias.
¿Cuándo conviene realizar un postmortem?
Suele ser especialmente útil después de incidentes críticos, eventos con impacto relevante en usuarios o negocio, fallas recurrentes, problemas que requirieron escalamiento importante o situaciones de las que pueden extraerse aprendizajes útiles.
¿Cuál es la diferencia entre causa raíz y detonante?
El detonante es el evento inmediato que inicia el incidente, mientras que la causa raíz explica por qué el sistema o proceso permitió que ese evento generara el impacto observado. Un buen análisis considera también factores contribuyentes.
¿Un postmortem debe identificar a la persona responsable del incidente?
El objetivo principal no debería ser asignar culpa individual. Es más útil analizar condiciones técnicas, procesos, controles, herramientas y decisiones que permitieron el incidente y definir mejoras que hagan el sistema más resistente.
¿Qué diferencia hay entre postmortem y análisis de causa raíz?
El análisis de causa raíz es una parte del postmortem. El postmortem normalmente también incluye impacto, línea de tiempo, detección, respuesta, decisiones, aprendizajes y acciones de mejora.
¿Qué debería tener una buena acción preventiva?
Debería describir un cambio concreto, tener un responsable, prioridad, fecha objetivo y un criterio verificable que permita determinar cuándo fue completada. También conviene relacionarla con el riesgo o hallazgo que busca reducir.
¿Debo compartir el postmortem con todo el equipo?
Depende de la sensibilidad del contenido, pero compartir los aprendizajes con los equipos relevantes ayuda a evitar que el mismo problema se repita en otros servicios. Antes de distribuirlo, revisá que no contenga información sensible.
¿Puedo usar esta plantilla para incidentes pequeños?
Sí. Podés simplificarla y completar solamente las secciones necesarias. Para incidentes menores puede alcanzar con un resumen, causa, aprendizaje y acciones, mientras que incidentes críticos suelen justificar un análisis más detallado.
Transparencia editorial
Recurso preparado y revisado por SG Hub
Esta ficha busca explicar no solo qué descargar, sino también cuándo utilizar el recurso y qué revisar antes de aplicarlo en una situación real.