Vista previa
Conocé el recurso antes de descargarlo
Resumen
Qué resuelve esta plantilla
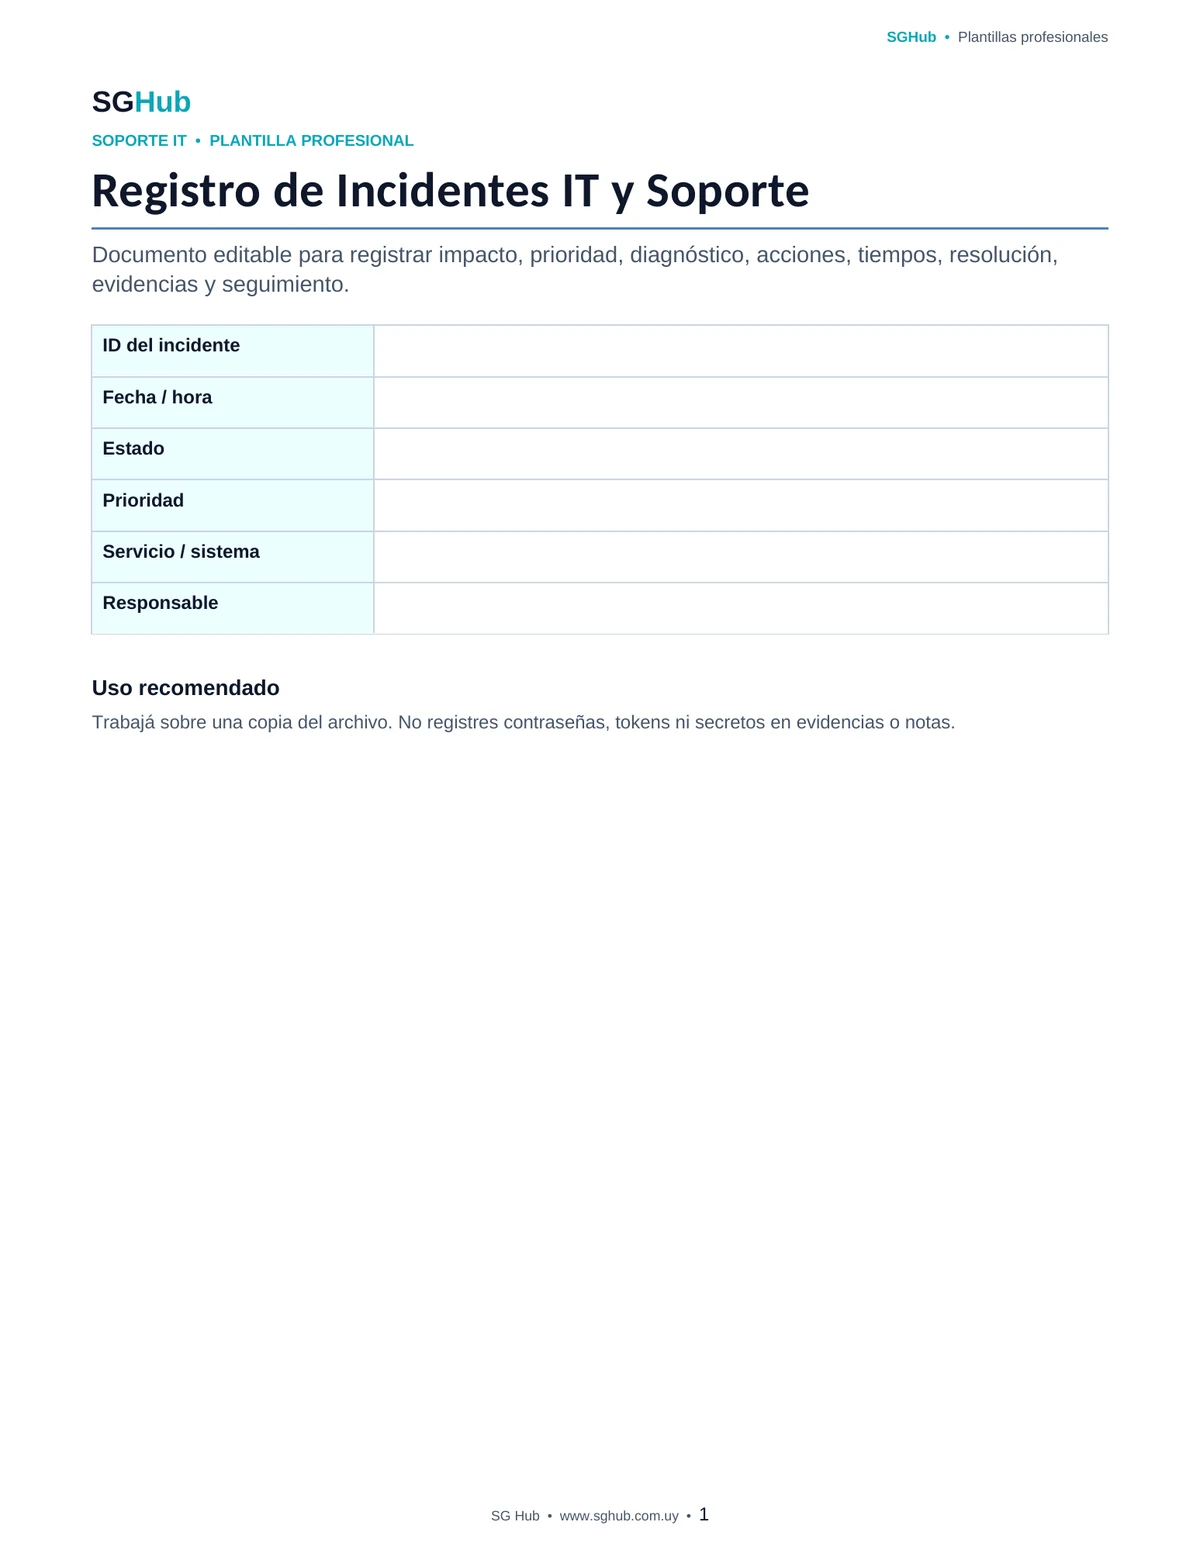
Esta plantilla está diseñada para centralizar el ciclo completo de un incidente IT desde su reporte inicial hasta el cierre y seguimiento. Ayuda a registrar qué ocurrió, quién fue afectado, cuál fue el impacto operativo, qué diagnóstico se realizó, qué acciones se ejecutaron y cómo se resolvió el problema. También permite conservar evidencia y decisiones útiles para futuras incidencias, análisis de tendencias, escalamiento y mejora continua del servicio de soporte.
Público
¿Para quién está pensada?
- ✓Equipos de soporte IT y mesa de ayuda que registran incidentes y solicitudes técnicas.
- ✓Analistas de aplicaciones y soporte productivo que necesitan documentar diagnósticos y resoluciones.
- ✓Administradores de sistemas, infraestructura y redes que participan en incidentes operativos.
- ✓Equipos de desarrollo que reciben incidentes escalados desde soporte.
- ✓Service Managers y responsables de operaciones que necesitan medir impacto, tiempos y recurrencia.
- ✓Pequeñas empresas y equipos internos que buscan profesionalizar el seguimiento de problemas técnicos.
Contenido
Qué incluye
- ✓Identificador, fecha, hora y estado del incidente.
- ✓Usuario, área, cliente o servicio afectado.
- ✓Categoría, subcategoría y origen del reporte.
- ✓Descripción inicial del incidente y síntomas observados.
- ✓Impacto operativo y alcance del problema.
- ✓Prioridad o severidad asignada.
- ✓Ambiente, aplicación, dispositivo o sistema involucrado.
- ✓Diagnóstico inicial y causa probable.
- ✓Acciones de análisis y resolución realizadas.
- ✓Responsables y equipos participantes.
- ✓Escalamientos y dependencias externas.
- ✓Tiempos de primera respuesta, atención y resolución.
- ✓Solución aplicada y resultado final.
- ✓Evidencias, logs, capturas o referencias.
- ✓Acciones de seguimiento y prevención de recurrencia.
Aplicación
Cuándo usar esta plantilla
Registrar incidentes reportados por usuarios a una mesa de ayuda.
Documentar fallas de aplicaciones, servicios, accesos, infraestructura o dispositivos.
Dar seguimiento a incidentes productivos que requieren participación de varios equipos.
Conservar un historial de diagnóstico y solución para problemas recurrentes.
Registrar escalamiento a desarrollo, proveedor, infraestructura o seguridad.
Medir tiempos de respuesta y resolución de incidentes.
Identificar tendencias y categorías con mayor volumen de soporte.
Documentar acciones posteriores al cierre para prevenir recurrencias.
Paso a paso
Cómo utilizarla
Paso 1
Asigná un identificador único al incidente y registrá fecha, hora, usuario o servicio afectado.
Paso 2
Describí los síntomas observados usando información concreta y evitando suponer una causa antes del análisis.
Paso 3
Clasificá el incidente por categoría, impacto, prioridad o severidad según los criterios utilizados por tu organización.
Paso 4
Registrá el ambiente, aplicación, versión, dispositivo o componente involucrado cuando sea relevante para reproducir el problema.
Paso 5
Documentá las verificaciones realizadas y el diagnóstico a medida que avanza el análisis.
Paso 6
Registrá cada acción importante, responsable y resultado para mantener trazabilidad durante el incidente.
Paso 7
Si es necesario escalar, indicá a qué equipo o proveedor se deriva y qué información se entregó.
Paso 8
Documentá la solución aplicada, validá con el usuario o servicio afectado y registrá el resultado final.
Paso 9
Calculá o registrá los tiempos de primera respuesta y resolución cuando sean relevantes para SLA o análisis operativo.
Paso 10
Antes de cerrar, identificá acciones de seguimiento, documentación o prevención si el incidente puede repetirse.
Personalización
Cómo adaptarla a tu caso
- ✓Adaptá prioridad, severidad, estados y categorías a los niveles utilizados por tu mesa de ayuda o proceso ITSM.
- ✓Agregá campos de SLA, número de ticket o herramienta de origen si utilizás Jira, ServiceNow, GLPI, Zendesk u otra plataforma.
- ✓Incluí campos específicos de aplicación, servidor, base de datos o ambiente cuando trabajes con soporte productivo.
- ✓Para incidentes críticos, agregá una línea de tiempo detallada con hora, acción, responsable y resultado.
- ✓Si necesitás análisis posterior, incorporá campos para causa raíz, problema relacionado y acción preventiva.
Importante
Qué revisar antes de usarla
- ✓Separá los síntomas observados del diagnóstico: registrar una causa no confirmada como hecho puede desviar el análisis.
- ✓La prioridad debería considerar impacto y urgencia, no solamente la percepción de quien reporta el incidente.
- ✓Documentar las acciones durante el incidente facilita escalamiento, continuidad entre turnos y análisis posterior.
- ✓No incluyas contraseñas, tokens, claves privadas u otros secretos en evidencias, logs o notas de soporte.
Evitalos
Errores frecuentes
- ✓Registrar descripciones vagas como “no funciona” sin indicar síntomas, pasos o contexto.
- ✓Asignar prioridad crítica a todos los incidentes sin evaluar impacto y urgencia.
- ✓Modificar el diagnóstico inicial sin conservar las acciones o hallazgos que llevaron al cambio.
- ✓No registrar quién realizó una acción importante ni cuándo fue ejecutada.
- ✓Escalar un incidente sin adjuntar la información mínima necesaria para continuar el análisis.
- ✓Cerrar un incidente sin validar que el servicio o usuario volvió a operar correctamente.
- ✓Confundir una solución temporal o workaround con una resolución definitiva.
- ✓Omitir logs, mensajes de error o evidencias que podrían facilitar futuros diagnósticos.
- ✓No relacionar incidentes repetidos que pueden indicar un problema estructural.
- ✓Guardar información sensible o credenciales dentro del registro del incidente.
Control final
Checklist antes de terminar
- ✓El incidente tiene un identificador único.
- ✓La fecha y hora del reporte están registradas.
- ✓El usuario, área o servicio afectado está identificado.
- ✓Los síntomas están descritos de forma concreta.
- ✓La categoría y prioridad fueron asignadas.
- ✓El impacto y alcance están documentados.
- ✓El ambiente o sistema involucrado está identificado.
- ✓Las verificaciones realizadas quedaron registradas.
- ✓El diagnóstico está diferenciado de los síntomas.
- ✓Las acciones importantes incluyen responsable y resultado.
- ✓Los escalamientos están documentados.
- ✓La solución o workaround aplicado está registrado.
- ✓El resultado fue validado antes del cierre.
- ✓Los tiempos de respuesta y resolución están registrados cuando corresponde.
- ✓Las evidencias necesarias están adjuntas o referenciadas.
- ✓Las acciones de seguimiento o prevención están definidas cuando corresponde.
Formato
Detalles del archivo
Documento editable orientado al registro y seguimiento de incidentes IT, mesa de ayuda y soporte de aplicaciones. Puede utilizarse como ficha individual por incidente o adaptarse a una planilla consolidada. Su estructura permite documentar impacto, prioridad, diagnóstico, acciones, responsables, tiempos, solución, evidencias y seguimiento, facilitando la trazabilidad operativa y la reutilización del conocimiento.
Preguntas frecuentes
Antes de descargar
¿Qué diferencia hay entre incidente y solicitud de servicio?
Un incidente representa una interrupción o degradación no planificada de un servicio, mientras que una solicitud de servicio suele ser una petición estándar, como un acceso, instalación o cambio previamente definido. La clasificación puede adaptarse al proceso utilizado por tu organización.
¿Cómo debería definir la prioridad de un incidente?
Una práctica habitual es combinar impacto y urgencia. Un incidente que afecta a muchas personas o a un proceso crítico puede tener mayor prioridad que uno limitado a un único usuario, aunque ambos necesiten atención.
¿Qué información mínima debería registrar?
Como mínimo conviene registrar fecha, usuario o servicio afectado, síntomas, impacto, prioridad, acciones realizadas, responsable, solución y estado final. Para problemas complejos también son útiles ambiente, logs, evidencias y dependencias.
¿Debo registrar todas las acciones realizadas?
No es necesario documentar cada clic, pero sí las acciones relevantes para comprender cómo evolucionó el diagnóstico, qué cambios se realizaron, quién participó y qué resultado produjo cada decisión importante.
¿Qué es un workaround?
Es una solución temporal que permite restaurar o continuar la operación sin eliminar necesariamente la causa del problema. Conviene identificarla claramente para no confundirla con una resolución definitiva.
¿Cuándo conviene escalar un incidente?
Cuando excede el conocimiento, permisos o alcance del equipo actual, cuando requiere intervención de otro sistema o proveedor, o cuando el impacto y los tiempos justifican involucrar un nivel superior de soporte.
¿Puedo utilizar esta plantilla para soporte de aplicaciones?
Sí. La estructura es especialmente útil para soporte de aplicaciones y producción porque permite registrar ambiente, versión, diagnóstico, logs, base de datos, dependencias, acciones y escalamiento a desarrollo o proveedores.
¿Qué debería revisar antes de cerrar un incidente?
Confirmá que el servicio o usuario recuperó la operación esperada, que la solución está documentada, que las evidencias necesarias fueron guardadas y que cualquier acción posterior o problema recurrente quedó identificado.
Transparencia editorial
Recurso preparado y revisado por SG Hub
Esta ficha busca explicar no solo qué descargar, sino también cuándo utilizar el recurso y qué revisar antes de aplicarlo en una situación real.